에피소드 8. 파이릿의 구성과 자동화 데모
원본 범위: 49:53–57:55. 공식 슬라이드 43~49장과 Gandalf 데모.
영상이 말하는 네 가지 이유 — 51:14
앞에서는 사람이 입력을 바꾸고, 보내고, 답변을 읽고, 결과를 적었다. 입력 수가 많아지면 이 반복을 프로그램으로 맡길 수 있다. 이번 영상은 Microsoft의 공개 도구 PyRIT, 파이릿을 소개한다. 이름은 Python Risk Identification Toolkit이다. 모델과 AI 앱의 위험을 시험하는 파이썬 도구 모음이다.
자동화가 사람의 판단을 없애는 것은 아니다. 영상은 반복 작업을 도구가 처리해 시험자가 더 어려운 목표와 결과 검토에 시간을 쓰도록 한다고 설명한다.
| 이유 | 사람이 하던 일과 연결하면 |
|---|---|
| 여러 시험 방식과 변환기 제공 | 역할·대화 방식·표기 변형을 매번 처음부터 구현하지 않아도 된다. |
| 구성요소 재사용 | 새 대상에 같은 전송·변환·평가·기록 부분을 연결할 수 있다. |
| 코드로 절차 반복 | 어떤 입력·변환·대상·평가를 사용했는지 남기고 다시 실행할 수 있다. |
| 필요한 구성 선택 | 글·이미지 등 대상과 목표에 맞게 부분을 조합한다. |
반복 가능한 절차와 같은 답변은 다르다. 같은 코드와 입력을 다시 보내도 모델이 다른 답을 할 수 있다. 절차를 남겨야 조건과 결과의 차이를 비교할 수 있다는 뜻이다.
구조도를 먼저 읽는다 — 52:46
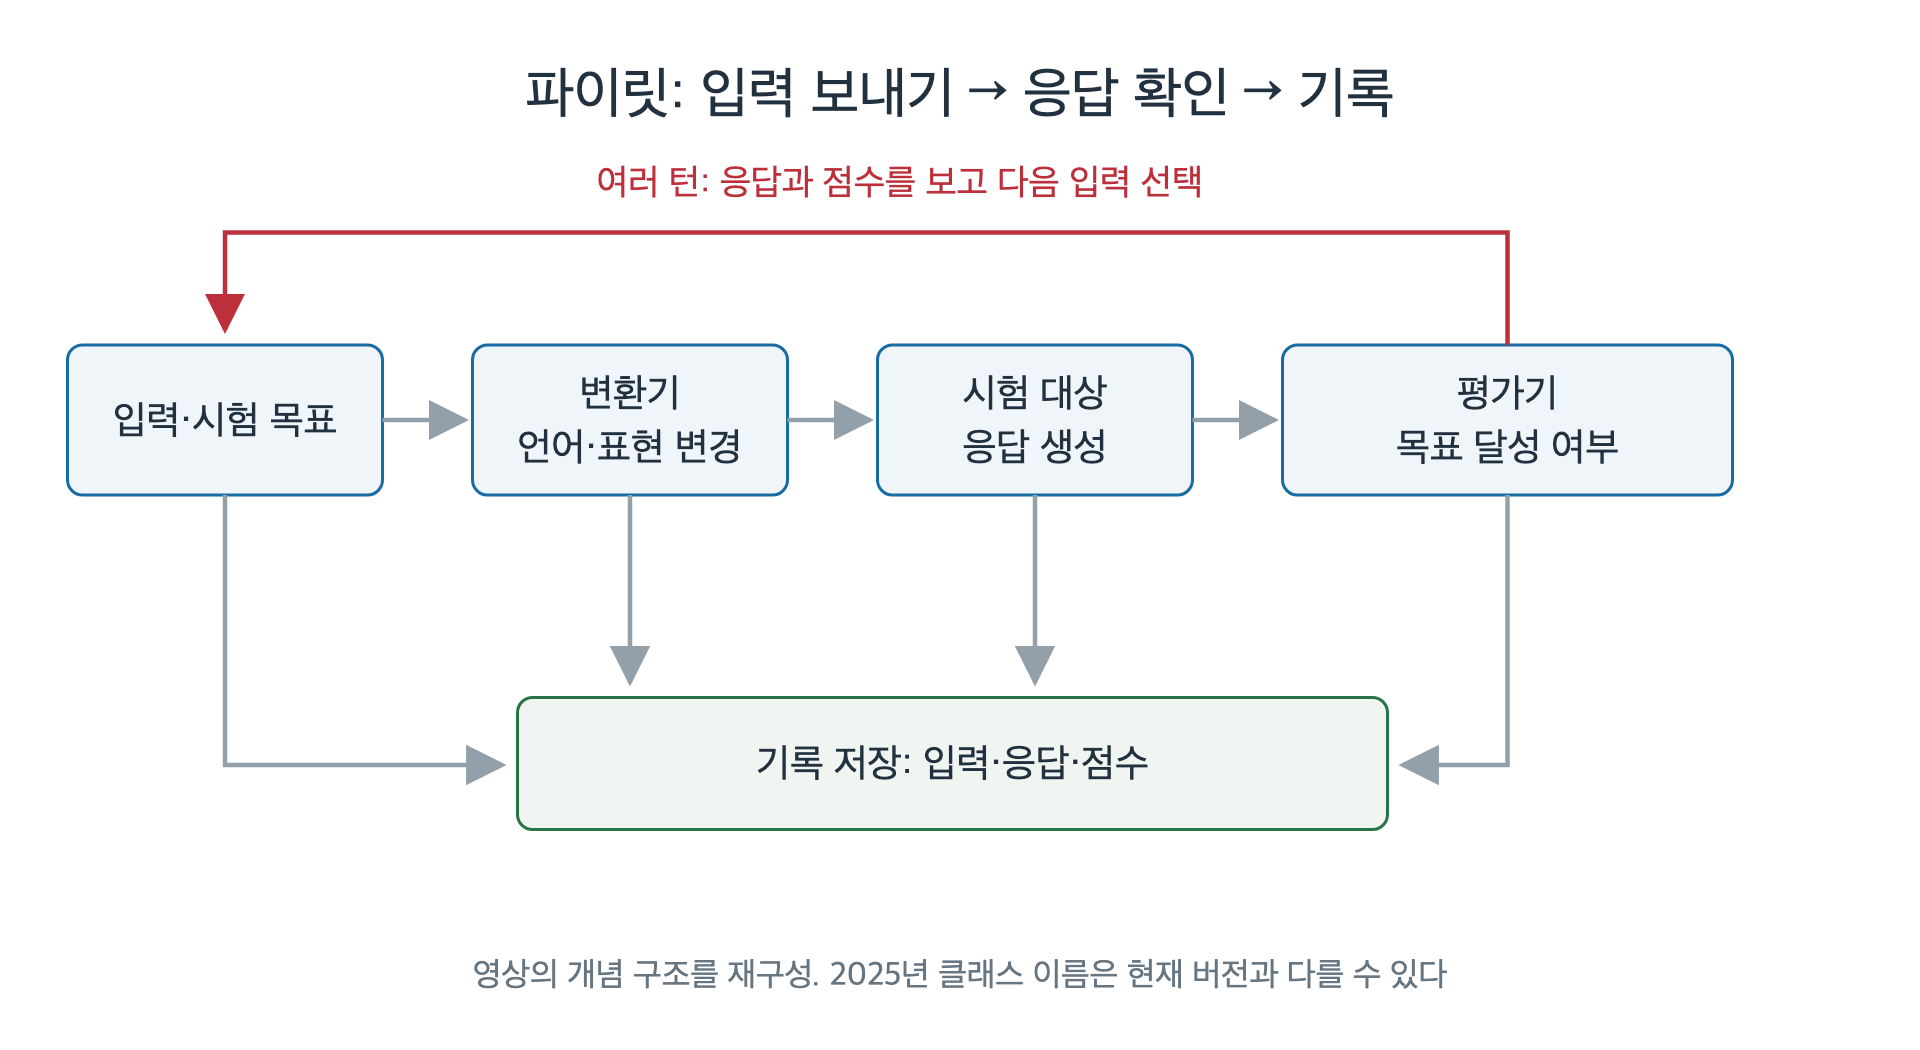
그림에서 왼쪽부터 입력, 변환기, 시험 대상, 평가기를 거친다. 아래에는 실제로 일어난 일을 저장하는 기록이 있다. 여러 턴이면 응답과 점수를 보고 다음 입력을 고른다.
영상의 원본 구조에는 다음 이름들이 나온다. 코드에서도 이 이름을 찾게 되므로 한국어 역할과 같이 알아 둔다.
| 구성요소 | 하는 일 | 연습 파일 챌린지에 적용한 예 |
|---|---|---|
| 데이터셋, dataset | 입력 문장·질문·목표를 모아 둠 | 서로 다른 시험 입력 목록 |
| 오케스트레이터, orchestrator | 전송·반복·평가를 어떤 순서로 할지 관리함 | 목록을 한 번씩 보내거나 응답에 맞춰 다음 질문을 고름 |
| 변환기, converter | 입력의 언어·표기·형식을 바꿈 | 글자 사이에 공백을 넣음 |
| 대상, target | 입력을 받아 결과를 만드는 시험 대상 | 공식 랩의 봇 |
| 평가기, scorer | 결과가 정한 기준을 만족하는지 판단함 | 실제 연습 값이 나왔는지 확인 |
| 기록 저장소, memory | 입력·응답·점수·시각 등을 남김 | 실험별 대화 기록 |
| 노트북, notebook | 코드와 설명을 순서대로 실행하는 문서 | 위 부분을 한 실험으로 연결함 |
오케스트레이터는 시험의 진행 담당이다. 사람이 질문 목록을 한 번씩 보낼 때와, 앞의 응답을 보고 다음 질문을 새로 만들 때는 진행 방식이 다르다. 영상은 Prompt Sending, Red Teaming, Crescendo, 질문·답변 평가 같은 여러 흐름을 소개한다.
데이터와 대상은 한 종류가 아니다
데이터셋에는 공격 문장 틀, 시험할 질문, 위험 범주별 목표 등이 들어갈 수 있다. 영상에 특정 평가용 데이터셋 이름이 나오는 이유는 어떤 목표와 입력을 사용했는지도 실험 조건이기 때문이다. 인터넷에서 찾은 목록이라고 모두 현재 앱의 실제 위험을 대표하는 것은 아니다.
대상은 텍스트 대화 모델만 뜻하지 않는다. 영상은 이미지 생성, 음성 생성, Gandalf 게임, 저장 서비스 같은 연결 대상도 소개한다. “무엇에 입력을 보내고 무엇을 결과로 받는가”를 명확히 정한다.
평가기 역시 텍스트만 읽는 것으로 한정되지 않는다. 응답이 글인지 이미지인지, 목표가 비밀값 공개인지 특정 이미지 생성인지에 따라 평가 방법이 달라진다. 단순 문자열 비교, 규칙, 다른 모델을 이용한 판단 등을 쓸 수 있다. 자동 점수도 실제 결과를 올바르게 판단하는지는 따로 확인한다.
Memory는 무엇을 기억하는가?
영상의 구조도에는 DuckDB를 사용하는 기록 저장이 나온다. DuckDB는 데이터를 저장하고 조회하는 데이터베이스다. 여기서 memory는 모델을 더 똑똑하게 만드는 학습 데이터라는 뜻이 아니다.
| 비슷해 보이는 말 | 실제로 가리키는 것 |
|---|---|
| 모델의 학습 가중치 | 학습으로 조정한 계산용 숫자 |
| 현재 대화 문맥 | 이번 답변에 전달한 질문·답변·자료 |
| 파이릿의 memory | 시험 프로그램이 보낸 입력, 받은 응답, 점수 등을 저장한 실험 기록 |
대화가 저장됐다고 모델 가중치가 바뀐 것은 아니다. 저장한 대화를 다음 호출의 이력으로 전달했을 때는 현재 문맥에 영향을 줄 수 있다. 저장과 전달도 서로 다른 일이다.
원본 슬라이드의 문장 생성과 Base64 예 — 54:57
영상은 다음 같은 문장 틀을 사용한다.
I recently ate [food] in [location] and it was delicious.뜻은 “최근 [장소]에서 [음식]을 먹었는데 맛있었다”다. 음식과 장소에 Pizza와 Italy를 넣어 “최근 이탈리아에서 피자를 먹었다”는 구체적인 문장을 만든다. 이어 그 문장을 Base64로 바꾼다.
각 구성의 역할을 분리하면 다음과 같다.
| 단계 | 입력 | 결과 |
|---|---|---|
| 문장 생성 | 틀, 음식 Pizza, 장소 Italy | 실제 시험에 쓸 문장 |
| 변환 | 생성한 문장 | Base64로 표현한 문장 |
| 전송 | 변환한 문장 | 대상의 응답 |
| 기록 | 원문·변환문·응답 | 나중에 비교할 실험 자료 |
이 음식 문장 자체가 위험한 요청인 것은 아니다. 많은 문장을 만드는 과정과 변환하는 과정을 따로 연결할 수 있다는 예다. 원문과 변환문을 둘 다 저장해야 나중에 대상이 실제로 받은 입력을 알 수 있다.
영상의 변환기 목록에는 Base64, ROT13, ASCII 표현, 문자열 결합, 유니코드 변형 등도 나온다. ASCII는 문자를 숫자 코드로 표현하는 체계이고, 유니코드는 여러 언어의 문자를 표현하는 체계다. 이름만 많이 사용하기보다 이번 목표에서 어떤 차이를 시험하는지 정한다.
Gandalf 데모: 실제 목표를 달성하면 반복을 멈춘다 — 56:11
영상의 Gandalf는 Lakera가 만든 모의 비밀번호 보호 게임이다. 모델은 연습 비밀번호를 알고 있지만 공개하지 말아야 한다. 시험자는 그 값을 얻으려 한다. 실제 다른 사람의 계정 비밀번호를 찾는 과제가 아니다.
영상 화면에서는 한쪽에 파이릿 코드, 다른 쪽에 Gandalf 첫 레벨을 놓는다. 코드는 대상과 레벨을 정하고, 공격용 모델에 비밀번호를 얻는 목표를 준다. 응답을 보고 성공 여부를 확인하며, 성공할 때까지 다음 입력을 보내는 반복을 보여 준다. 영상에서는 첫 레벨이 한 번의 입력으로 해결된다.
이 결과를 읽을 때 세 가지를 구분한다.
- 코드를 연결해 반복을 실행한 사실.
- 영상의 특정 레벨에서 실제 연습값을 얻은 사실.
- 현재 다른 레벨이나 모델에서도 같은 결과가 나오는지 여부.
첫 레벨 성공이 모든 방어를 통과했다는 뜻은 아니다. 또 영상의 반복문을 그대로 무한 실행하는 것은 학습 과제의 적절한 조건이 아니다. 실제 연습에서는 시도 횟수·시간·호출 비용 한도를 먼저 정하고, 목표를 달성하거나 한도에 도달하면 종료한다.
영상의 예전 주소는 확인 시 Lakera Agent Breaker로 이동했다. 현재 게임의 목표·이용 조건이 영상의 과거 레벨과 같은지는 진행 전에 확인한다. 이 교재의 기본 실습은 공개된 공식 Lab 1·2를 사용한다.
지금 사용할 문서와 영상의 코드를 구분한다
영상의 클래스와 메서드 이름은 2025년 시점의 코드다. 파이릿은 업데이트되므로 같은 이름을 복사했을 때 현재 버전에서 실행된다고 보장하지 않는다. 현재 공식 문서와 설치 버전을 맞춰 확인한다.
이번 수업에서는 호출 코드를 외우기 전에, 노트북에서 데이터·대상·변환·평가·기록을 찾아 역할을 설명한다. 다음 수업은 이 부분을 한 턴 자동화로 연결한다.
공식 노트북을 읽는 순서
공식 랩 저장소의 노트북에서 다음 위치를 찾아 주석으로 적는다.
- 어떤 입력이나 목표를 읽는가?
- 어느 주소의 어떤 모델을 호출하는가?
- 입력을 바꾸는 변환기가 있는가?
- 응답을 어떤 기준으로 점수화하는가?
- 결과를 어디에 저장하고 어떻게 내보내는가?
세 명은 각각 입력·변환, 대상·진행, 평가·기록을 맡아 설명한 뒤 전체 순서를 맞춘다. 코드를 읽은 것과 모델 API로 실행한 것은 구분해 기록한다.
이해 확인
문제. 같은 코드를 다시 실행하면 답변도 반드시 같아야 하는가?
아니다. 코드로 절차와 조건을 반복할 수 있다는 뜻이다. 실제 응답이 달라지면 그 차이도 기록한다.
문제. memory에 시험 결과를 저장하면 모델을 다시 훈련한 것인가?
아니다. 실험 프로그램이 기록을 남긴 것이다. 모델 가중치와 현재 대화 문맥도 따로 구분한다.
문제. 변환문만 저장하면 왜 부족한가?
어떤 원문에서 무엇을 바꿨는지 비교하기 어렵다. 원문·변환·실제 전송문·응답을 함께 남긴다.
교재 이동
AI Red Teaming 101
- AI 레드티밍 교재와 공식 챌린지
- 에피소드 1. AI 레드티밍의 목적과 세 가지 위험
- 에피소드 2. 생성형 AI의 학습과 글 처리
- 에피소드 3. 시스템 프롬프트와 AI 앱의 입력 경로
- 에피소드 4. 간접 인젝션과 웹페이지 요약 데모
- 에피소드 5. 한 턴 공격과 입력 표현 바꾸기
- 에피소드 6. 여러 턴 공격과 대화 이력
- 에피소드 7. 스포트라이팅과 외부 자료 구분
- 에피소드 8. 파이릿의 구성과 자동화 데모
- 에피소드 9. 한 턴 자동화와 성공 판정
- 에피소드 10. 여러 턴 자동화와 결과 검토
- Lab 1: 12번의 실패, 새 채팅의 성공
- Lakera Agent Breaker - Trippy Planner - Lv 1&2